 GxPSoft AI
2026년 생명과학 분야의 모든 AI 피칭은 항상 같은 말로 마무리됩니다: “당사의 AI는 밸리데이션된 고객의 콘텐츠에 에이전트를 그라운딩하는 지식 그래프를 갖추고 있습니다.” 그리고 2026년 생명과학 AI 프로젝트의 모든 실패 역시 항상 같은 지점에서 시작됩니다: 지식 그래프라고 부르던 것은 사실 특정 벤더의 단순한 문서 저장소에 불과했고, 에이전트는 단일 QMS 테이블 하나만 읽고 있으며, 고객 데이터는 사일로에 갇혀 있고, 감사 추적(Audit Trail)은 스크린샷 캡처에 불과하며, 규제 기관 감사관이 “데이터 계보(lineage)를 입증하라”고 요구했을 때 제출할 수 있는 답변은 고작 CSV 파일 다운로드뿐이기 때문입니다.
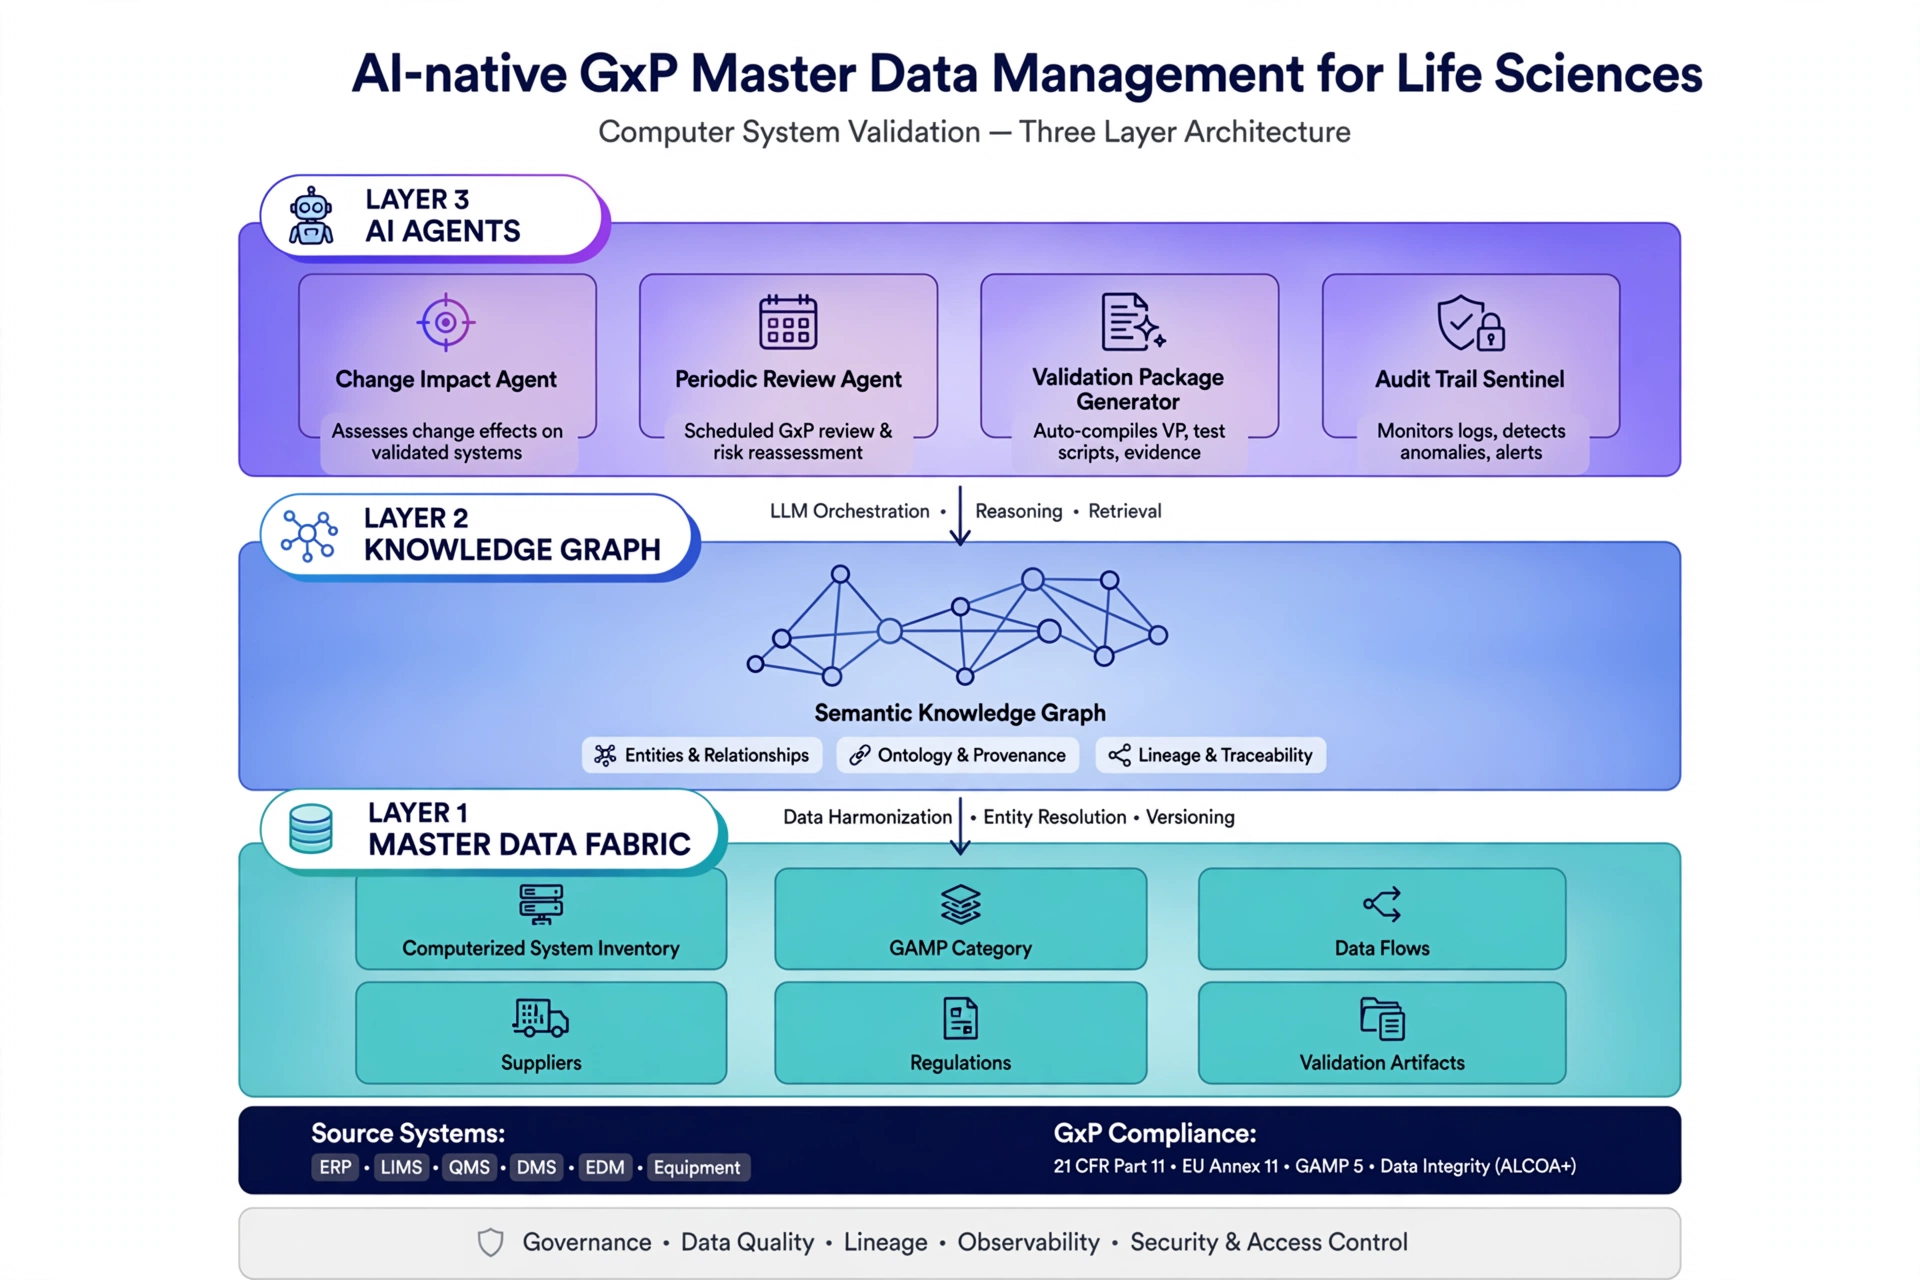
위의 다이어그램은 이러한 피칭을 규제 당국 앞에서 실제로 방어 가능(defensible)하게 만드는 구체적인 아키텍처 패턴입니다. 세 개의 뚜렷한 계층으로 구성됩니다. 최하단에는 21 CFR Part 11, EU Annex 11, GAMP 5, 그리고 ALCOA+ 데이터 완전성(Data Integrity) 원칙으로 이루어진 규제 기질(Substrate)이 자리합니다. 그 위로 거버넌스, 데이터 품질, 계보 추적, 관측 가능성(Observability), 보안 및 접근 제어가 횡단적 역량(cross-cutting capabilities)으로 시스템 전체를 관통합니다. 원천 시스템(ERP, LIMS, QMS, DMS, EDM, 제조 장비)은 최하단의 데이터 정합성·조정(Harmonization) 계층으로 데이터를 공급합니다. 최상단에는 AI 에이전트 계층이 위치하며, 그 사이 중심을 바로 **밸리데이션 데이터 패브릭(Validation Data Fabric)**이 지탱합니다.
우리는 지난 90일 동안 이 기술 스택을 구성하는 벤더 맵(Kneat, ValGenesis, MasterControl, Veeva, Purolea 경고 서한, FDA CSA 가이드라인 확정안, ISPE GAMP AI 가이드 등)을 면밀히 분석하고 기록해 왔습니다. 오늘 우리는 그 아키텍처 자체를 정립하고자 합니다. 왜냐하면 벤더 맵을 분석할 때마다 끊임없이 떠오르는 본질적인 질문에 대한 해답이 바로 이 아키텍처 안에 있기 때문입니다. 그 질문은 “어느 벤더가 가장 뛰어난 AI를 가지고 있는가”가 아닙니다. **임의의 AI 에이전트를 GxP 환경에서 규제 방어 가능하게 만들어 주는 데이터 기질(Substrate)은 무엇인가?**입니다.
구속 제약(Binding Constraint)은 모델이 아니라 데이터다
2026년 4월 2일, 미국 FDA는 21 CFR 211.22(c) 위반을 이유로 AI의 오남용을 명시적으로 지적한 최초의 경고 서한(Warning Letter)을 발행했습니다(대상: 미시간주 리보니아 소재 Purolea Cosmetics Lab, FEI 3011669383). FDA 조사관은 해당 기업이 적절한 품질 관리 감독(Quality Control oversight) 없이 “AI 에이전트”를 활용하여 의약품 규격, 제조 절차서 및 생산 기록을 작성했음을 적발했습니다. RAPS의 보도에 따르면, 경고 서한은 “적절한 품질 관리 부서의 감독 없이 의약품 규격, 절차 및 생산 기록을 생성하는 데 인공지능(AI)에 과도하게 의존한 점”을 엄중히 질타했습니다. Purolea 경고 서한은 AI를 GxP 위반의 직접적 원인으로 명시한 FDA 최초의 법적 집행 조치입니다. 그리고 이것이 마지막이 아닐 것입니다.
Purolea 사례가 업계에 주는 본질적인 교훈은 사용된 AI 모델 자체가 “성능이 나빴다”는 점이 아닙니다. AI가 회사가 규제 당국 앞에서 방어할 수 없는 데이터를 기반으로 구동되었다는 점입니다. 에이전트가 참조할 버전이 고정된 온톨로지(ontology)가 존재하지 않았습니다. AI의 출력물은 밸리데이션된 특정 공식 기록에 결합되지 않았습니다. 감사 추적 시스템은 Part 11 수준의 데이터 계보를 입증할 수 없었습니다. 에이전트를 배포하기 전에 데이터 계보가 구조적으로 캡처되지 않았기 때문입니다. 즉, 이 실패의 본질은 모델의 결함이 아니라 데이터 계층의 결함이었습니다.
이것이 바로 절대적인 구속 제약입니다. 파운데이션 모델은 언제든 교체될 수 있습니다. 그러나 규제 데이터 기질은 대체할 수 없습니다. AI 에이전트가 소비하는 거버넌스되고, 버전이 고정되며, 계보가 추적되고, 규제 조항과 완벽히 앵커링된 마스터 데이터 계층을 장악하는 벤더가, GxP 엔터프라이즈 내의 모든 AI 역량이 구동되는 핵심 인프라를 지배하게 됩니다. 기질 위에 얹힌 에이전트는 교체 가능하지만, 그 밑의 데이터 기질은 영속적입니다.
이것이 바로 2024~2026년에 걸쳐 Veeva, MasterControl, ValGenesis, Kneat 등이 선보인 에이전틱 AI 기능들이 모두 동일한 아키텍처 패턴으로 수렴하는 이유이기도 합니다. 즉, 승인이 아닌 ‘초안 작성’, 서명이 아닌 ‘제안’, 원시 CRUD 엔드포인트를 마구 호출하는 에이전트가 아닌 ’밸리데이션된 엔벨로프(envelope) 내부에서만 구동되는 에이전트’라는 형태입니다. 패턴이 곧 모델이며, 모델은 데이터의 하류(downstream)에 위치합니다.
이 아키텍처를 필연으로 만든 3가지 규제 동인
규제 및 시장의 세 가지 강력한 흐름이 2026년에 이 3계층 아키텍처를 정답으로 만들었습니다:
1. FDA CSA(컴퓨터 소프트웨어 보증) 가이드라인 공식 확정 (2025년 9월 24일 발행, 2026년 2월 3일 개정). ‘생산 및 품질 시스템 소프트웨어를 위한 컴퓨터 소프트웨어 보증(CSA)’ 최종 가이드라인은 EU Annex 11 이후 CSV 분야에서 발생한 가장 거대한 규제 패러다임의 전환입니다. NSF 보고서에 명시되었듯, “최종 지침은 2025년 9월 24일에 발표되었으며… 2026년 2월 3일에 업데이트 버전이 발행되었습니다.” CSA는 “소프트웨어가 환자의 안전 및 제품 품질에 미치는 위험도에 알맞은 수준의 보증 활동을 적용하라(Right assurance for the right risk)“고 명시합니다. 이는 AI 벤더들이 GxP 환경에서 LLM의 유효성을 방어하기 위해 반드시 취해야 하는 논리와 완벽히 일치합니다. 즉, AI는 중간 위험도이자 대량 반복 업무인 URS 초안 자동 작성, 일탈 내용 자동 요약, 위험 분류 자동 제안 등에서는 가장 뛰어난 규제 방어력을 갖지만, 최고 위험도의 최종 품질 결정 영역에서는 가장 위험합니다. CSA와 AI의 접점은 에이전트 계층을 지탱하는 규제적 앵커입니다. 그리고 데이터 계층은 지식 그래프의 모든 노드를 CSA 위험 등급에 정밀하게 매핑함으로써 이 앵커를 뒷받침해야 합니다.
2. ISPE, ‘GAMP Guide: Artificial Intelligence’ 공식 발간 (2025년 7월). ISPE.org 및 ISPE Pharmaceutical Engineering 2025년 9/10월호를 통해 확인된 이 가이드는 GAMP 5 밸리데이션 라이프사이클을 모델 컨텍스트, 학습 데이터, 드리프트(drift) 모니터링, 재밸리데이션 트리거 영역으로 공식 확장했습니다. ISPE AI 가이드는 에이전트 계층을 위한 방법론적 기준점입니다. 또한 이는 데이터 계층의 방법론적 기준점이기도 합니다. 에이전트의 프롬프트, 검색기(retriever), 도구 API가 이제 정식 ’구성 항목(Configuration Item)’으로 취급되며, 이 구성 항목들은 반드시 밸리데이션된 원천 코퍼스로 거슬러 올라가 추적 가능해야 하기 때문입니다.
3. Purolea 경고 서한 (2026년 4월 2일)이 던진 규제 집행 현실. 에이전트의 입력, 출력, 검색된 참조 문서, 도구 호출 내역, 그리고 최종 승인한 인간 담당자에 대한 Part 11 수준의 완벽한 감사 추적(Audit Trail)을 생성하지 못하는 아키텍처는 규제 기관의 실사를 통과할 수 없습니다. 데이터 계층은 이러한 감사 추적을 가능케 하는 구조적 기반입니다. 그래프는 쿼리 기질이고, 에이전트는 애플리케이션 계층이며, 감사 추적은 이 세 가지를 하나로 묶는 횡단적 역량입니다.
이 세 가지 힘이 결합하여 아키텍처를 위 다이어그램에 제시된 3계층 패턴으로 강력하게 수렴시키고 있습니다. 이 규제 동인들은 아키텍처의 존재 이유라기보다, 이 아키텍처가 규제 당국 앞에서 방어력을 가질 수 있는 유일한 근거입니다.
다이어그램으로 보는 3개 계층의 세부 구조
다이어그램의 각 계층은 고유하고 엄격한 책임을 갖습니다. 이 책임을 혼동하는 순간 아키텍처 전체가 무너집니다.
계층 1 — 마스터 데이터 패브릭 (Master Data Fabric: 기질)
GxP 규제 대상 엔티티들이 거버넌스되고, 버전이 엄격히 고정되며, 계보가 추적되고, ALCOA+ 데이터 완전성을 준수하는 데이터 저장소입니다. ISPE GAMP 5 제2판 Appendix M3, 폐쇄형 QMS 벤더 온톨로지, FDA CSA 위험 질문 프레임워크를 기반으로 도출된 핵심 표준 엔티티는 다음과 같습니다:
- 컴퓨터화 시스템 인벤토리(Computerized System Inventory) — 시스템 버전, 벤더, GAMP 카테고리(1~5), GxP 영향도, 호스팅 모델, SOUP/COTS 분류, 밸리데이션 상태, 소유자, 최근 밸리데이션 일자, 차기 정기 검토(Periodic Review) 일정을 포함한 모든 밸리데이션 대상 시스템 목록.
- GAMP 카테고리(GAMP Category) — GAMP 5 제2판 분류 체계: 카테고리 1(인프라 소프트웨어), 카테고리 3(비구성 COTS), 카테고리 4(구성된 COTS), 카테고리 5(맞춤형 커스텀 소프트웨어).
- 데이터 흐름(Data Flows) — 시스템 간 인터페이스, 데이터 유형, 필드별 ALCOA+ 속성, 데이터 보존 주기, 저장 시 암호화(Encryption-at-rest), 타임스탬프 시각 동기화 체계.
- 공급업체(Suppliers) — 공급업체 감사 기록, 벤더 릴리스 노트, SLA, 적격성 평가 상태, SOC 2 / ISO 27001 인증서.
- 규정(Regulations) — 세부 조항 수준 매핑: 21 CFR Part 11.10(a), Annex 11 조항 7, GAMP 5 제2판 App M3, ISPE AI 가이드, CSA 위험 질문 세트, ICH Q9 (품질 리스크 관리 / FMEA).
- 밸리데이션 산출물(Validation Artifacts) — URS(사용자 요구사항 규격서), FRS, IQ/OQ/PQ 스크립트, RTM(요구사항 추적성 매트릭스), 정기 검토 보고서 등. 모두 버전 관리되고 ALCOA+ 태그가 부여되며 이를 생성한 시스템 엔티티와 링크됨.
이 엔티티 모델 바로 아래 위치한 **데이터 정합성·조정 계층(Data Harmonization Layer)**은 이기종 원천 시스템의 파편화된 데이터를 수집하여 표준 골든 레코드(Golden Record)로 통합하는 엔티티 식별(Entity-resolution) 및 버전 관리 엔진입니다. 다이어그램에는 ERP, LIMS, QMS, DMS, EDM, 제조 장비의 6개 원천 시스템이 명시되어 있습니다. 데이터 조정 계층이 존재해야만 원천 시스템 데이터가 비로소 쿼리 가능한 형태로 변환됩니다.
계층 1이 규제 방어력을 갖는 이유: 에이전트 스택의 다른 모든 계층이 전적으로 이 계층에 의존하기 때문입니다. 패브릭에 존재하지 않는 데이터에 대해 그래프는 관계를 추론할 수 없습니다. 그래프가 없다면 에이전트는 신뢰할 수 있는 초안을 작성할 수 없습니다. 데이터 계보가 없다면 감사 추적은 규제 당국 앞에서 방어될 수 없습니다. 마스터 데이터 패브릭이야말로 진정한 핵심 기질입니다.
계층 2 — 지식 그래프 (Knowledge Graph: 시맨틱 계층)
계층 1 엔티티들 사이에 형성된 의미론적(semantic) 관계망입니다. 지식 그래프는 다음을 가능하게 합니다:
- 온톨로지 및 출처(Ontology & Provenance) — 모든 엔티티가 규제 조항, GAMP 카테고리, 리스크 점수, 통제 항목, 테스트된 산출물과 명시적으로 연결됩니다.
- 엔티티 및 관계(Entities & Relationships) — 모든 관계는 엄격한 타입(type)이 지정되고, 버전 관리되며, 상태가 추적됩니다.
- 계보 및 추적성(Lineage & Traceability) — 지식 그래프 자체가 곧 살아있는 감사 추적(Audit Trail)입니다. 실사관이 “시스템 X에 대한 밸리데이션 증적을 보여달라”고 요구할 때, 단순 문서 검색이 아닌 결정론적인 그래프 순회(Graph Traversal)를 통해 즉각 증명할 수 있습니다.
그래프가 계층 1이 아닌 계층 2인 이유: 그래프는 데이터 자체의 물리적 실체가 아니라 **데이터의 표현(Representation)**이기 때문입니다. 데이터가 사전에 정규화되고 표준화(canonical)되어야 비로소 그래프로 엮일 수 있습니다. 2024~2025년 많은 기업들이 데이터 패브릭 없이 그래프부터 구축하려다 실패했던 뼈아픈 실수를 이제 업계는 바로잡고 있습니다.
그래프가 최상단 계층이 아닌 이유(에이전트가 그 위에 위치하는 이유): 에이전트는 지식 그래프를 기질로 소비하는 주체이지, 그 반대가 아니기 때문입니다. 에이전트가 온톨로지를 스스로 만들어내는 것이 아닙니다. 온톨로지는 GxP 규제 프레임워크와 고객의 확정된 데이터로부터 엄격하게 큐레이션됩니다.
계층 3 — AI 에이전트 (AI Agents: 애플리케이션 계층)
다이어그램에 명시된 4대 표준 에이전트이자, 2026년 CSV/CSA 도입 기업들이 가장 시급히 요구하는 에이전트들입니다:
- 변경 영향 평가 에이전트 (Change Impact Agent) — 벤더 패치, 구성 변경, 인프라 업데이트 등의 변경이 시스템의 밸리데이션 상태에 미치는 영향을 다각도로 평가합니다.
그래프 순회 경로: 시스템 → 요구사항 → 위험 → 테스트 스크립트 → 증적 → SOP → 연계 영향 시스템 → 감사 추적.
출력물: GxP 영향 평가서, 리스크 평가서, 테스트 계획서 초안. 최종 승인은 인간이 전자 서명합니다. - 정기 검토 에이전트 (Periodic Review Agent) — 밸리데이션된 시스템에 대해 주기적(기본 연 1회) 정기 검토를 수행합니다.
그래프 순회 경로: 시스템 → 발생 장애/인시던트 → 일탈 기록 → 감사 추적 메트릭 → 미결 CAPA → 사용자 권한 변경 내역 → 공급업체 업데이트.
출력물: 정기 검토 보고서 초안. 인간 책임자가 검토 후 서명합니다. - 밸리데이션 패키지 생성기 (Validation Package Generator) — 신규 도입 시스템 또는 재밸리데이션을 위한 전체 패키지를 자동 조립합니다.
입력: 대상 시스템 + 사용 목적(Intended Use).
그래프 순회 경로: GAMP 템플릿 → 요구사항 템플릿 → 위험 템플릿 → 테스트 템플릿 → RTM 템플릿.
출력물: 밸리데이션 계획서(VP), URS/FRS/DS, 위험 평가서(RA), IQ/OQ/PQ 스크립트, RTM, 밸리데이션 요약 보고서(VSR). 인간 검증 후 서명. - 감사 추적 센티널 (Audit Trail Sentinel) — 시스템의 실시간 감사 추적 이벤트를 지속적으로 모니터링합니다.
입력: 시스템의 실시간 감사 추적 로그.
그래프 순회 경로: 시스템 → 감사 추적 규격서 → ALCOA+ 무결성 규칙 → 위반 사항 식별.
출력물: 이상 징후 분석 보고서, 즉각적인 알림(Alert). 인간이 위험도를 분류(triage)하고 후속 조치를 취합니다.
계층 2와 계층 3 사이에 위치한 **LLM 오케스트레이션 · 추론 · 검색 경계(LLM Orchestration · Reasoning · Retrieval boundary)**가 바로 LLM 자체가 동작하는 지점입니다. 다시 강조하지만 LLM은 교체 가능한 부품입니다. 교체 불가능한 것은 그래프입니다. LLM의 역할은 그래프를 순회하고, 연관 노드를 검색하여, 인간이 검토할 정교한 초안 문서를 조립하는 것입니다. LLM의 역할은 엔티티를 날조하거나, 임의의 관계를 상상하거나, 규제 조항 매핑을 멋대로 지어내는 것이 결코 아닙니다. LLM이 무언가를 스스로 발명해야 하는 상황이 발생한다면, 그것은 아키텍처 설계가 실패했음을 의미합니다.
기저의 규제 준수 및 운영 기질
다이어그램의 맨 아래 바닥은 규제 기질: 21 CFR Part 11 · EU Annex 11 · GAMP 5 · 데이터 완전성(ALCOA+)입니다. 데이터를 건드리는 모든 산출물에는 ALCOA+ 태그가 붙어야 합니다. 모든 서명은 Part 11을 준수해야 합니다. 모든 감사 추적은 Annex 11 요구사항을 만족해야 합니다. 이 기질은 단순한 하나의 계층이 아닙니다. 상위의 모든 계층이 필수적으로 만족해야 하는 전제 조건입니다.
규제 기질 바로 위에 위치한 횡단 역량 계층 — 거버넌스 · 데이터 품질 · 계보 추적 · 관측 가능성 · 보안 및 접근 제어 — 은 시스템의 지속적 운영 계층(operations layer)입니다. 모든 엔티티는 거버넌스를 거쳐야 합니다. 모든 변경은 버전이 매겨져야 합니다. 모든 접근은 기록되어야 합니다. 모든 데이터 품질 규칙은 데이터 작성 시점(write time)에 강제 적용되어야 합니다. 시스템 배포 이후 발생하는 Day-2 운영 비용의 성패가 바로 이 영역에서 결정됩니다.
다이어그램이 의도적으로 보여주지 않는 세 가지
다이어그램에 명시적으로 그려지지 않았으나 매우 중요한 세 가지 요소가 있습니다:
- 특정 LLM 모델 그 자체. 다이어그램은 LLM을 특정 벤더의 상용 제품 이름이 아닌, L2→L3 경계의 범용 역량으로 표시했습니다. LLM은 언제든 교체 가능한 기술이기 때문입니다. 진정한 기술적 해자는 기질에 있습니다. 오늘 이 아키텍처를 Claude 기반으로 구축한 벤더는 내일 밸리데이션 데이터 패브릭을 한 줄도 수정하지 않고 GPT-5.6으로 손쉽게 전환할 수 있습니다. 기업의 핵심 자산은 밸리데이션된 데이터 코퍼스이지 모델이 아닙니다.
- 특정 소프트웨어 벤더의 명칭. 이 다이어그램은 순수한 아키텍처 패턴입니다. 이를 완벽히 제품화할 벤더는 아직 시장에서 확정되지 않았습니다. 2026년 8월 20일 현재, 다이어그램에 그려진 완전한 3계층 아키텍처를 온전히 출시한 단일 벤더는 없습니다. 대다수 벤더는 계층 1(레코드 저장소) 안에 계층 2(그래프)를 가두고 계층 3(자체 에이전트)과 묶어 폐쇄형 사일로로 판매하고 있으며, 타사 시스템과의 연동을 차단하고 있습니다. 이 다이어그램은 벤더 중립적인 목표 아키텍처를 제시하며, 바로 이 간극이 새로운 거대한 시장 기회입니다.
- 컴플라이언스 루프 내 강제화 메커니즘(Compliance-in-the-loop enforcement). 다이어그램은 데이터 계층과 에이전트 계층을 엄밀하게 정의했습니다. 그러나 “에이전트가 올바르게 작동하고 있음을 규제 기관 감사관에게 입증하는 절차적 강제 메커니즘”은 감사 추적 센티널을 통해 암묵적으로 언급될 뿐 별도의 블록으로 명시되지 않았습니다. 이는 2026~2028년 업계가 구체적인 표준으로 완성해야 할 과제입니다.
구매 평가를 위한 10대 질문
2026년에 밸리데이션 데이터 패브릭을 도입하려 하거나, 특정 벤더의 “AI 솔루션”이 진정한 데이터 패브릭 기반인지 검증하고자 한다면 다음 10가지 질문을 던져야 합니다:
- 귀사의 마스터 데이터 계층은 네이티브 그래프 데이터베이스(Graph DB)인가요, 아니면 관계형 DB 위에 그래프 뷰만 씌운 형태인가요? 네이티브 그래프 DB(Neo4j, Amazon Neptune 등)는 관계 순회를 자연스럽게 처리합니다. 반면 관계형 DB는 쿼리 시점에 대규모 JOIN을 강제하므로 대규모 환경에서 성능 저하와 감사 추적 공백이 발생합니다.
- 지식 그래프 온톨로지는 GxP 전용으로 사전 구축되었습니까, 아니면 범용 온톨로지에 규제 산업용 커넥터만 붙인 형태입니까? GxP 전용으로 사전 구축된 온톨로지만이 유효합니다. 범용 온톨로지에 껍데기만 씌우는 방식은 이미 수많은 실패를 낳은 과거의 접근법입니다.
- 엔티티 식별 및 해결(Entity resolution) 과정이 버전 관리됩니까? 모든 엔티티 레코드는 버전, 타임스탬프, 변경 계보를 반드시 보유해야 합니다. 벤더가 “이력 관리가 된다”고 모호하게 답한다면 구체적인 데이터 스키마를 요구하십시오.
- LLM은 범용 규제 코퍼스가 아닌, 고객사가 직접 승인하고 밸리데이션한 문서 코퍼스에 엄격히 그라운딩됩니까? ValGenesis의 VAL™ 출시 보도자료에서 표현했듯 *“전체 밸리데이션 수명주기 전반에 걸친 신뢰할 수 있는 가드레일”*이 고객사의 승인된 밸리데이션 문서에 직접 적용되어야 합니다. 범용 인터넷 규제 문서를 참조하는 모델은 오답입니다.
- 에이전트의 프롬프트, 검색 인덱스(RAG), 툴 허용 목록이 변경 제어 하에 놓인 밸리데이션 구성 항목으로 관리됩니까? 모델 버전만 고정하는 것으로는 부족합니다. 검색 인덱스, 프롬프트 템플릿, 툴 권한 목록 역시 엄격한 구성 관리 대상이어야 합니다.
- 고객 데이터가 타사 고객을 위한 모델 학습이나 파인튜닝에 사용되지 않는다는 보장이 계약서에 명시됩니까? 절대로 사용되어서는 안 되며, 계약서 조항은 여러 예외 단서가 붙은 긴 문단이 아니라 “어떠한 경우에도 학습에 사용되지 않는다”는 명확한 단문이어야 합니다.
- 에이전트의 입력, 출력, 검색된 문서, 도구 호출, 인간 승인자가 호출 단위(per-call)로 완벽히 결합되어 감사 추적에 기록됩니까? 이 다섯 가지 요소가 단 하나라도 누락되면 Purolea 사태와 같은 치명적인 규제 지적을 피할 수 없습니다.
- 벤더가 ISO 42001(인공지능 경영시스템) 인증을 획득했습니까? MasterControl이 2025년 7월 15일 주요 벤더 중 최초로 인증을 획득했습니다. CSV/CSA 벤더의 경우 이미 인증을 받았거나 심사를 진행 중이어야 합니다. 2027~2028년에는 기본 필수 요건이 될 것입니다.
- 이 AI 기능이 특정 등급 시스템의 IQ/OQ 밸리데이션을 축소하거나 면제해 줄 수 있습니까? 고위험 시스템의 경우 IQ/OQ는 필수적으로 유지됩니다. 저위험 시스템의 경우 이미 CSA 지침에 따라 검토 기반 보증이 가능합니다. AI는 생산성 증폭기일 뿐, 스스로 밸리데이션을 대체할 수 없습니다. 만약 벤더가 “우리 AI가 IQ/OQ를 완전히 대체합니다”라고 주장한다면 그 아키텍처는 잘못된 것입니다.
- 해당 AI 기능이 벤더의 표준 밸리데이션 패키지에 포함되어 있습니까, 아니면 AI 재밸리데이션을 전적으로 고객이 수행해야 합니까? 벤더는 AI 컴포넌트, 모델 버전, 데이터 입력 체계, 인간 승인 검문소, 감사 추적 연동을 명시한 IQ/OQ 추가 문서(addendum)를 제공해야 합니다. “AI 밸리데이션은 고객의 책임”이라고 떠넘긴다면 Part 11 준비가 되어 있지 않은 시스템입니다.
벤더가 이 질문들에 대해 *“우리는 최첨단 AI를 쓰기 때문에 마법처럼 다 됩니다”*라고 얼버무린다면, 그 미팅은 즉시 종료해야 합니다.
2026년 중반 기준 여전히 미해결된 과제들
- 다이어그램에 그려진 완전한 3계층 아키텍처를 독립적으로 상용화할 벤더가 등장할 것인가? 이 패턴을 가장 먼저 개방형으로 출시하는 벤더가 2026
2028년 차세대 시장을 제패할 것입니다. 자체 폐쇄형 QMS 안에 특정 에이전트를 가두어 파는 방식(20242025년의 레거시 GTM)은 구시대의 유물이 될 것입니다. - FDA CSA 최종 확정안이 2026년 내에 업계 공통의 ‘CSA 부합 AI 방법론 백서’ 발행을 촉진할 것인가? 방법론 자체는 수렴하고 있지만(CSA + AI 브리지, ISPE AI 가이드, ISO 42001), 공인된 표준 백서 산출물은 아직 부재합니다. 가장 먼저 공개 백서를 내놓는 벤더가 업계의 실사 표준을 주도할 것입니다.
- ISPE GAMP AI 가이드(2025년 7월)가 GxP AI의 실질적인 사실상 표준(de facto)으로 안착할 것인가, 아니면 FDA의 후속 지침이 이를 대체할 것인가? FDA의 2021년 SaMD AI/ML 가이드는 오래되었고, ISPE 가이드는 최신입니다. 한편 의약품 제조 내 AI 활용에 관한 FDA 공식 지침은 여전히 심의 대기 중입니다. 규제 위계 구조는 아직 확정되지 않았습니다.
- Purolea 경고 서한(2026년 4월 2일)은 일회성 사건인가, 규제 강화 폭풍의 서막인가? GMP Compliance 분석에 따르면 해당 서한은 GxP 위반의 직접 원인으로 “AI 에이전트”를 명시했습니다. 규제 소프트웨어 분야의 에이전틱 AI 시대는 규제 기관의 철퇴와 함께 시작되었습니다. 관건은 FDA가 2026~2027년 실사에서 AI 규정 준수를 핵심 테마로 삼을 것인가입니다.
- 폐쇄형 QMS 벤더(Veeva, MasterControl, ETQ, TrackWise, Greenlight Guru, Qualio)가 2026년 4분기까지 공식 1자(First-party) MCP 서버를 출시할 것인가? 2026년 8월 현재 어떤 폐쇄형 QMS 벤더도 자체 MCP 서버를 공식 제공하지 않고 있습니다. MCP(Model Context Protocol)는 에이전트 시대를 잇는 핵심 프로토콜입니다. 이를 먼저 제공하는 벤더가 폐쇄형 사일로를 벗어나 개방형 에이전트 생태계로 통하는 다리를 놓게 됩니다.
- 밸리데이션 데이터 패브릭이 업계 표준 오픈소스 온톨로지로 공개될 것인가, 독점 자산으로 남을 것인가? ‘GxP를 위한 쿠버네티스(Kubernetes for GxP)’ 베팅은 실재합니다. 온톨로지를 오픈소스화하는 기업은 패브릭을 산업 전체의 기본 인프라로 만들고 에이전트를 차별화 포인트로 삼을 것입니다. 반대로 이를 독점하는 기업은 패브릭을 폐쇄적 해자로 유지하고 에이전트를 부가 기능으로 묶어둘 것입니다.
결론
2026년 GxP AI 스택의 핵심 연산 장치(CPU)는 거대 언어 모델이 아닙니다. 밸리데이션 데이터 패브릭입니다. LLM은 패브릭을 읽고, 지식 그래프를 순회하며, 신속하게 초안을 작성해 주는 고속 주변 장치(peripheral)에 불과합니다. 영속하는 것은 패브릭입니다. 모델은 끊임없이 진화하고 바뀌지만, 규제 데이터 기질은 영원합니다.
이 기질을 규제 당국 앞에서 방어 가능하게 만드는 아키텍처는 에이전트를 내부에 가둔 폐쇄형 QMS가 아닙니다. 마스터 데이터 패브릭 + 지식 그래프 + AI 에이전트로 이어지는 3계층 아키텍처이며, 그 기저를 받치는 GxP 규제 준수 기질과 계층 전체를 관통하는 횡단 운영 체계(거버넌스, 데이터 품질, 계보 추적, 관측성, 보안)입니다. 밸리데이션 데이터 패브릭이 본질적인 기질이며, 에이전트는 애플리케이션일 뿐이고, 기질이 곧 무너지지 않는 기술적 해자입니다.
이제 던져야 할 올바른 질문은 어느 벤더가 최고의 AI 모델을 가졌는가가 아닙니다. **해당 벤더의 소프트웨어 스택이 호출 단위별로, 시스템별로, 변경 건별로 에이전트의 입력, 출력, 참조 문서, 도구 호출, 인간 승인자를 결합한 Part 11 방어 가능한 완벽한 감사 추적을 생성해 내는가?**입니다. 만약 그렇다면 그 아키텍처는 견고합니다. 만약 그렇지 못하다면, 그 시스템은 다음번 Purolea 경고 서한의 주인공이 될 시한폭탄에 불과합니다.
이 글의 기반이 된 전체 종합 리서치 자료는 Obsidian 볼트의 gxp_validation_data_fabric_2026-08-20에 보관되어 있습니다. 관련 추천 아티클:
- 바텀업 SaaS가 저물 때, GxP 규제 바닥은 이미 준비되어 있었다 — 소프트웨어 스택의 역전 현상과 오늘날 지능이 실제로 위치하는 곳에 대한 2026년 8월 분석
- Part 11 환경에서 CSV 및 CSA 벤더들이 AI를 출시하는 방법 — Kneat, ValGenesis, Veeva, MasterControl, Sparta/Honeywell, GoVal, eQCM 등 2026 CSV/CSA 벤더별 정밀 비교
- 폐쇄형 QMS 벤더들은 외부 AI 에이전트에게 문을 열고 있는가? — 2026년 8월 기준 폐쇄형 QMS, API, MCP 연동 현황 심층 리서치
- 마스터 데이터가 타사 플랫폼 종속으로 들어가면 안 되는 이유 — 벤더 호스팅 MDM의 한계와 자체 데이터 주권 확보 전략 (전략 A vs 전략 B)
GxPSoft AI는 GxP 규제를 준수하는 오픈소스 개발자 도구와 에이전틱 인터페이스를 구축하고 있습니다. 밸리데이션 데이터 패브릭 설계, GxP 네이티브 마스터 데이터 계층 구축, LLM의 Part 11 감사 추적 파이프라인 결합에 대해 논의가 필요하시다면 언제든 duke.lee@saram.io로 연락 주시기 바랍니다.